BT9G LABS / DHT 深度解析 #08
DHT Crawler 如何发现 InfoHash:主动查询、网络观察与负责任设计
从系统角度解释 DHT crawler 如何发现 InfoHash,以及为什么发现、Metadata 获取和索引必须拆成不同流水线。
BT9G Labs / DHT Deep Dive #08. 把 DHT 发现从 Metadata 采集里拆出来,理解主动 lookup、观察事件、热路径和网络礼貌之间的平衡。
快速摘要
- 主题: DHT Crawler 如何发现 InfoHash:主动查询、网络观察与负责任设计
- 核心关键词: DHT crawler, InfoHash 发现, 主动查询, Metadata pipeline, BitTorrent
- 适合读者: 后端工程师、协议研究者、搜索工程师以及 BitTorrent 实现者
- 目标: 用足够准确的协议与系统视角解释原理,并能直接支持真实的采集、索引和搜索架构设计。
系统视图
发现与获取是两条不同流水线
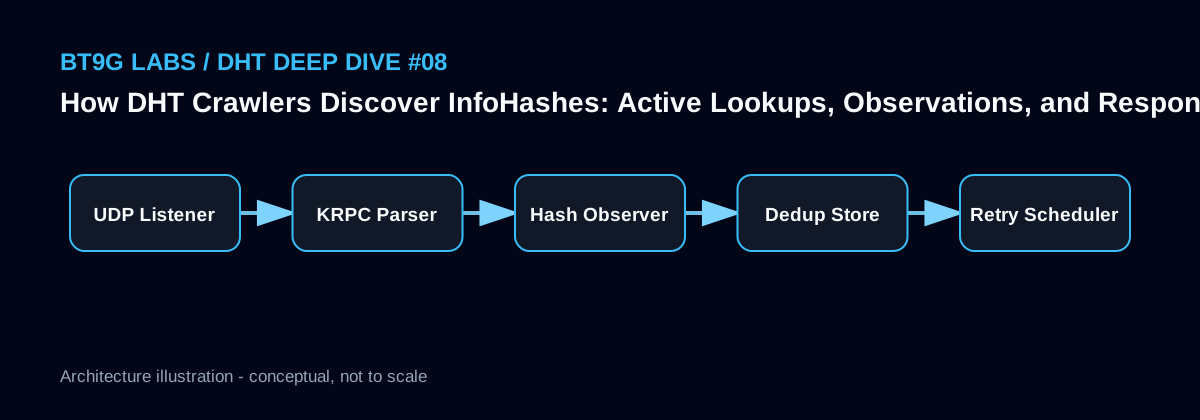
DHT crawler 最容易犯的架构错误,是把“看到一个 InfoHash”立即等同于“必须同步拿完 Metadata”。发现事件通常非常便宜且密集,而建立 Peer 连接、扩展握手和传输 Metadata 明显更昂贵。
更合理的系统把 UDP discovery 作为高速入口,只做最小解析、去重和持久化,然后把需要尝试 Metadata 的哈希放入异步队列,由另一组 worker 按资源预算处理。这样才能在突发流量下保持稳定。
主动策略与观察策略
主动 crawler 可以选择目标键空间并执行 find_node / get_peers,借此不断探索网络。另一方面,长期参与 DHT 本身也会收到其他节点发来的查询,从中观察到新的 InfoHash。两种方式各有偏差,不应假装能够完整代表整个互联网。
高质量实现会记录每个发现信号的来源类型,以便后续判断一个哈希是由主动探索发现、对端请求暴露,还是其他数据源补充。
热路径应该非常轻
UDP packet handler 不适合执行数据库慢查询、Metadata 连接或复杂文本处理。它应该快速验证报文、提取必要字段、更新有限状态并把后续工作交给有界队列。所有可能阻塞的任务都应从 packet plane 中剥离。
如果入口速度超过下游处理能力,系统必须有 backpressure 或降级策略,而不是无限增加内存队列。否则短暂流量高峰就可能导致 OOM。
负责任的网络行为
DHT 是公共 P2P 网络,不是无限免费的扫描基础设施。crawler 应限制每节点请求频率、避免对同一地址重复轰炸、使用合理 timeout,并遵守正常协议交互。为了追求数字好看而制造大量无效查询,会降低自身成功率,也会给其他参与者带来负担。
工程优化的目标应该是单位请求获得更高质量的信息,而不是简单最大化 UDP 包数量。
实现示意
func handlePacket(pkt []byte, from *net.UDPAddr) {
    msg, err := krpc.Parse(pkt)
    if err != nil { return }
    routing.Observe(msg.NodeID, from)
    if ih, ok := msg.InfoHash(); ok {
        observer.TryEmit(HashEvent{Hash: ih, SeenAt: time.Now()})
    }
}
BT9G Labs 工程笔记
对 BT9G 一类索引系统而言,最重要的不是单纯追求事件数量,而是把内容身份、网络观察、采集状态和搜索文档拆成清晰的数据层。所有来自 DHT 或 Peer 的字段都应该保留来源与时间戳,并通过阶段化指标区分发现、连接、协商、Metadata 获取、校验、入库和索引等环节。这样才能在规模扩大后定位真实瓶颈,而不是把所有失败都归因于“网络不稳定”。
常见误区
- 每观察到一个哈希就同步启动 Metadata 抓取。
- 在 UDP handler 里执行数据库和网络慢任务。
- 宣称单一采集策略覆盖全网。
- 为了吞吐量对相同节点进行高频重复查询。
相关 BT9G Labs 文章
- DHT Routing Table 内部原理:k-Bucket、节点 Churn 与联系人选择
- 为什么 DHT 会看到海量 InfoHash?理解互联网规模的 Swarm 发现
- Magnet 链接如何变成文件 Metadata:完整 Peer 与 Metadata 流程
- BEP 9 ut_metadata 详解:如何从 Peer 获取 Torrent Metadata
参考资料
下一篇: Magnet 链接如何变成文件 Metadata:完整 Peer 与 Metadata 流程 →
本文用于解释公开的 BitTorrent 协议与工程实现思路,不代表任何被观察到的 Swarm 一定可用、有效或被授权传播。