
BT9G LABS / DHT Deep Dive #07
Почему DHT видит так много InfoHash: Swarm discovery в масштабе интернета
Почему наблюдатель DHT получает огромный поток активных, повторных, устаревших и низкокачественных InfoHash.
BT9G Labs / DHT Deep Dive #07. Объясняем происхождение потока хешей и почему количество observation events не равно количеству полезных Metadata.
Краткое резюме
- Тема: Почему DHT видит так много InfoHash: Swarm discovery в масштабе интернета
- Ключевые слова: DHT InfoHash, Swarm discovery, BitTorrent activity, deduplication, DHT crawler
- Для кого: backend-разработчики, исследователи протоколов, инженеры поисковых систем и разработчики BitTorrent-клиентов
- Цель: Объяснить механизм достаточно точно, чтобы на его основе можно было принимать реальные архитектурные решения для краулинга, индексации и поиска.
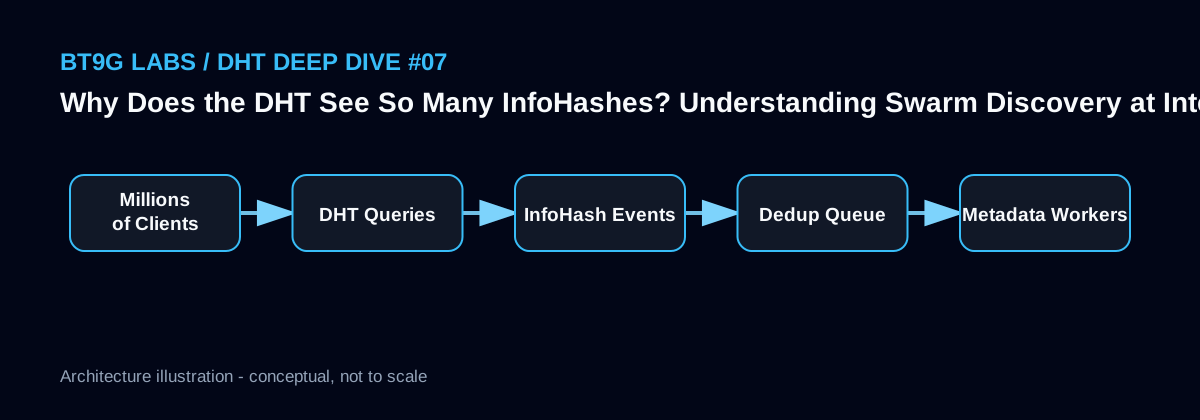
Системная схема
Нет центрального реестра InfoHash
DHT не содержит глобального списка всех Torrent. InfoHash появляются в поле зрения узла из реальных запросов, announce и активного обхода ключевого пространства. Набор, который видит один crawler, зависит от позиции в сети, времени онлайн, стратегии запросов и качества routing table.
Поэтому метрика «новых хешей в день» всегда относится к конкретному наблюдателю и методике, а не к абсолютной мировой цифре.
Поток содержит много шума
Один и тот же популярный InfoHash может встретиться тысячи раз. Другие хеши могут относиться к мертвым Swarm, ошибочным клиентам или намеренному мусору. Высокий packet rate еще ничего не говорит о числе новых индексируемых объектов.
Нужно разделять observation events, unique hashes, active hashes и metadata-success hashes — иначе красивый график может в основном показывать повторы.
Deduplication и активность
Повторные наблюдения лучше использовать как сигнал: обновлять last_seen, activity score и счетчик событий, не создавая каждый раз новый Metadata job. Быстрый hot dedup слой резко снижает стоимость сети и хранилища.
Активность полезна для ранжирования, но не является точным количеством пользователей или загрузок. Ее стоит комбинировать с успешностью Peer, Tracker-данными и свежестью Metadata.
Эскиз реализации
INSERT INTO infohash_observation(infohash, first_seen, last_seen, seen_count)
VALUES (?, NOW(), NOW(), 1)
ON DUPLICATE KEY UPDATE
  last_seen = VALUES(last_seen),
  seen_count = seen_count + 1;
Инженерные заметки BT9G Labs
Для индексатора уровня BT9G важнее не максимальное число событий, а правильное разделение идентичности контента, краткоживущих сетевых наблюдений, состояния сбора и поискового представления. Поля, полученные из DHT или от Peer, должны иметь источник и временную метку. Метрики стоит вести по этапам: discovery, соединение, handshake, поддержка расширений, получение Metadata, проверка, сохранение и индексация. Это позволяет видеть реальное узкое место системы, а не списывать все неудачи на «нестабильную сеть».
Типичные ошибки
- Называть поток одного crawler точным глобальным приростом.
- Смешивать events и unique InfoHash.
- Запускать Metadata fetch на каждый повтор.
- Интерпретировать DHT activity как точное число скачиваний.
Связанные статьи BT9G Labs
- BEP 5: ping, find_node, get_peers и announce_peer на уровне DHT-сообщений
- Внутри DHT routing table: k-bucket, churn и выбор контактов
- Как DHT crawler обнаруживает InfoHash: активный поиск, наблюдение и ответственная архитектура
- Как Magnet link превращается в Metadata: полный путь через Peer и расширения BitTorrent
Источники
Материал описывает публичное поведение протоколов BitTorrent для инженерных и исследовательских целей и не означает, что любой наблюдаемый Swarm доступен, корректен или разрешен к распространению.