
BT9G LABS / DHT Deep Dive #08
Как DHT crawler обнаруживает InfoHash: активный поиск, наблюдение и ответственная архитектура
Системный разбор discovery InfoHash в DHT и правильного разделения discovery, Metadata acquisition и indexing.
BT9G Labs / DHT Deep Dive #08. Почему быстрый UDP ingestion должен быть отделен от дорогих соединений с Peer и как не превращать crawler в генератор бесполезного трафика.
Краткое резюме
- Тема: Как DHT crawler обнаруживает InfoHash: активный поиск, наблюдение и ответственная архитектура
- Ключевые слова: DHT crawler, InfoHash discovery, active lookup, Metadata pipeline, BitTorrent
- Для кого: backend-разработчики, исследователи протоколов, инженеры поисковых систем и разработчики BitTorrent-клиентов
- Цель: Объяснить механизм достаточно точно, чтобы на его основе можно было принимать реальные архитектурные решения для краулинга, индексации и поиска.
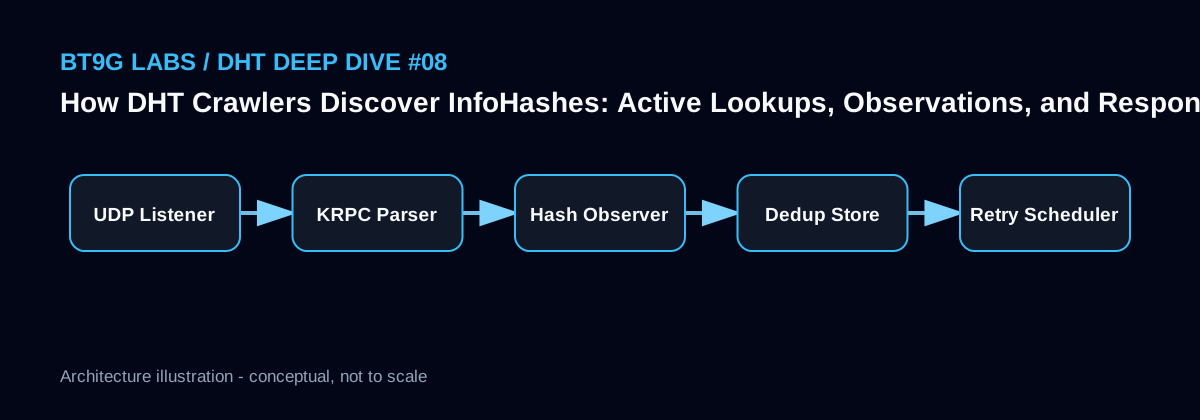
Системная схема
Discovery и acquisition — разные конвейеры
Увидеть InfoHash дешево; найти Peer, подключиться, договориться о расширениях и получить Metadata намного дороже. Поэтому UDP hot path должен только валидировать пакет, извлекать минимум данных, выполнять быстрый dedup и отправлять событие в bounded queue.
Отдельный scheduler решает, когда и с каким приоритетом запускать Metadata work. Это защищает packet plane от замедления downstream-сервисов.
Активные и наблюдательные стратегии
Crawler может сам выполнять find_node/get_peers, исследуя пространство ключей, а также получать новые InfoHash из входящих запросов других участников. У каждого источника собственное смещение. Полезно сохранять discovery_source, чтобы позже понимать, откуда появился хеш.
Ни один одиночный метод не гарантирует полный обзор всей мировой DHT.
Backpressure и сетевой этикет
Если downstream отстает, система должна снижать скорость активного обхода, сливать дубликаты и ограничивать очереди, а не бесконечно расходовать RAM. Запросы к одному удаленному узлу также нужно rate-limit-ить и использовать разумные timeout.
Оптимизация должна повышать полезную информацию на запрос, а не просто максимизировать число UDP-пакетов.
Эскиз реализации
func handlePacket(pkt []byte, from *net.UDPAddr) {
    msg, err := krpc.Parse(pkt)
    if err != nil { return }
    routing.Observe(msg.NodeID, from)
    if ih, ok := msg.InfoHash(); ok {
        observer.TryEmit(HashEvent{Hash: ih, SeenAt: time.Now()})
    }
}
Инженерные заметки BT9G Labs
Для индексатора уровня BT9G важнее не максимальное число событий, а правильное разделение идентичности контента, краткоживущих сетевых наблюдений, состояния сбора и поискового представления. Поля, полученные из DHT или от Peer, должны иметь источник и временную метку. Метрики стоит вести по этапам: discovery, соединение, handshake, поддержка расширений, получение Metadata, проверка, сохранение и индексация. Это позволяет видеть реальное узкое место системы, а не списывать все неудачи на «нестабильную сеть».
Типичные ошибки
- Синхронно тянуть Metadata на каждый новый hash event.
- Делать медленные DB/connection операции внутри UDP handler.
- Объявлять одну стратегию полным представлением всей DHT.
- Многократно бомбардировать один и тот же node ради throughput.
Связанные статьи BT9G Labs
- Внутри DHT routing table: k-bucket, churn и выбор контактов
- Почему DHT видит так много InfoHash: Swarm discovery в масштабе интернета
- Как Magnet link превращается в Metadata: полный путь через Peer и расширения BitTorrent
- BEP 9 ut_metadata: как получать Torrent Metadata от Peer
Источники
Материал описывает публичное поведение протоколов BitTorrent для инженерных и исследовательских целей и не означает, что любой наблюдаемый Swarm доступен, корректен или разрешен к распространению.