
BT9G LABS / DHT em profundidade #07
Por que a DHT vê tantos InfoHash? Swarm Discovery em escala de Internet
Por que um observador DHT recebe um grande fluxo de InfoHash ativos, repetidos, antigos e de baixa qualidade.
BT9G Labs / DHT Deep Dive #07. Diferencie volume de eventos, hashes únicos e Metadata realmente recuperável.
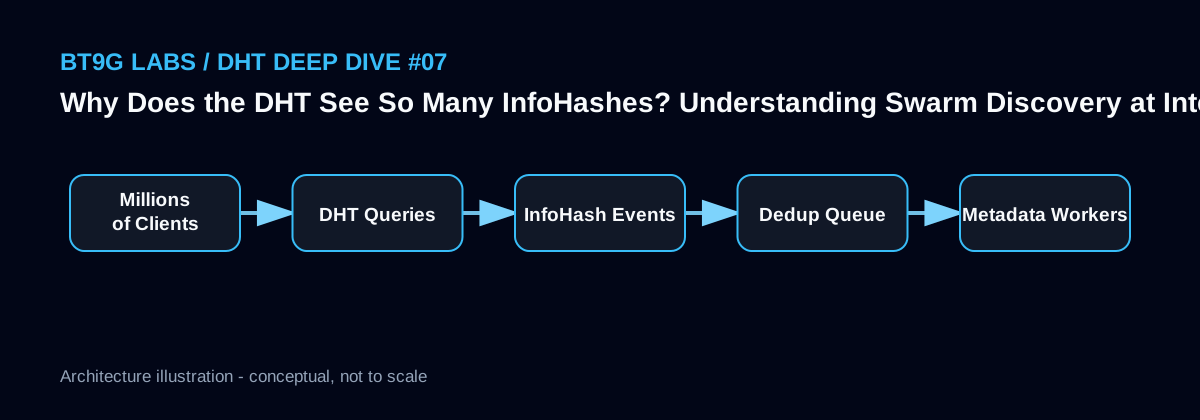
Resumo rápido
- Tema: Por que a DHT vê tantos InfoHash? Swarm Discovery em escala de Internet
- Palavras-chave: DHT InfoHash, Swarm discovery, BitTorrent activity, deduplication, DHT crawler
- Público: engenheiros backend, pesquisadores de protocolos, engenheiros de busca e implementadores de BitTorrent
- Objetivo: Explicar o mecanismo com precisão suficiente para orientar decisões reais de arquitetura de crawling, indexação e busca.
Visão do sistema
Não existe um registro central de InfoHash
A DHT não possui um catálogo global de Torrents. InfoHash aparecem por queries, announces e exploração ativa do key space. O conjunto visto por um crawler depende de uptime, posição na rede, estratégia e qualidade da routing table.
Assim, qualquer número de “novos hashes por dia” deve ser ligado a uma metodologia específica, não apresentado como total mundial absoluto.
O fluxo contém repetição e ruído
Um InfoHash popular pode aparecer milhares de vezes. Outros podem vir de Swarms mortos, clientes com bugs ou ruído malicioso. Um packet rate alto não significa a mesma quantidade de conteúdo novo indexável.
É melhor separar observation events, unique hashes, active hashes e metadata-success hashes.
Deduplication e activity signal
Quando um hash conhecido aparece novamente, o sistema pode atualizar last_seen, counters e activity score em vez de iniciar outro Metadata fetch. Bloom filters e hot caches reduzem bastante o custo desse hot path.
Activity é útil como sinal de ranking, mas não é um número exato de usuários ou downloads globais.
Esboço de implementação
INSERT INTO infohash_observation(infohash, first_seen, last_seen, seen_count)
VALUES (?, NOW(), NOW(), 1)
ON DUPLICATE KEY UPDATE
  last_seen = VALUES(last_seen),
  seen_count = seen_count + 1;
Notas de engenharia do BT9G Labs
Em um indexador como o BT9G, é mais importante separar corretamente a identidade do conteúdo, observações de rede de curta duração, estado de aquisição e documentos de busca do que maximizar o número bruto de eventos. Campos derivados de DHT ou de um Peer devem manter origem e timestamp, e as métricas devem ser divididas por etapas: discovery, conexão, handshake, suporte a extensões, obtenção de Metadata, validação, armazenamento e indexação.
Erros comuns
- Chamar a visão de um único crawler de total global.
- Misturar eventos com InfoHash únicos.
- Refazer Metadata fetch em cada repetição.
- Interpretar DHT activity como download count exato.
Artigos relacionados do BT9G Labs
- Mensagens DHT do BEP 5: ping, find_node, get_peers e announce_peer
- Por dentro de uma DHT Routing Table: k-Bucket, Node Churn e seleção de contatos
- Como um DHT Crawler descobre InfoHash: Active Lookup, observação e design responsável
- De Magnet Link a Metadata: fluxo completo de Peer Discovery e BEP 9/10
Referências
Este artigo descreve o comportamento de protocolos públicos do BitTorrent para fins de engenharia e pesquisa; não implica que todo Swarm observado esteja disponível, seja válido ou autorizado para redistribuição.