
BT9G LABS / DHT em profundidade #08
Como um DHT Crawler descobre InfoHash: Active Lookup, observação e design responsável
Como separar discovery de InfoHash, Metadata acquisition e indexação em um crawler DHT escalável.
BT9G Labs / DHT Deep Dive #08. Separe o hot path UDP das conexões caras com Peer e construa crawling útil sem gerar tráfego desnecessário.
Resumo rápido
- Tema: Como um DHT Crawler descobre InfoHash: Active Lookup, observação e design responsável
- Palavras-chave: DHT crawler, InfoHash discovery, active lookup, Metadata pipeline, BitTorrent
- Público: engenheiros backend, pesquisadores de protocolos, engenheiros de busca e implementadores de BitTorrent
- Objetivo: Explicar o mecanismo com precisão suficiente para orientar decisões reais de arquitetura de crawling, indexação e busca.
Visão do sistema
Discovery e acquisition são pipelines diferentes
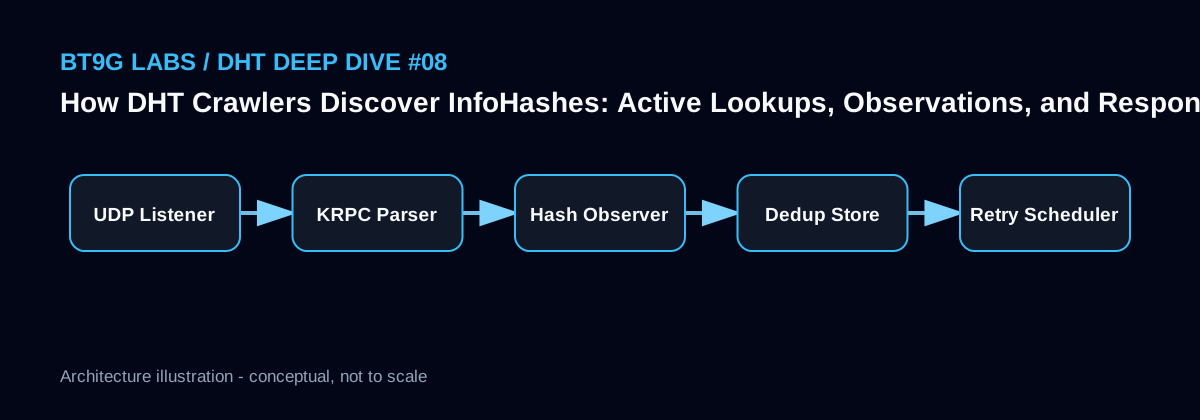
Observar um InfoHash é barato; localizar Peer, conectar e transferir Metadata é caro. O handler UDP deve validar pacotes, extrair poucos campos, fazer dedup rápido e publicar em uma bounded queue. Metadata workers trabalham de forma assíncrona.
Assim um downstream lento não bloqueia o packet plane.
Estratégias ativas e observacionais
Um crawler pode enviar find_node/get_peers para explorar ativamente o key space e também observar InfoHash presentes nas queries recebidas de outros nodes. Cada origem tem vieses; registrar discovery_source permite analisá-los depois.
Nenhuma técnica isolada representa perfeitamente toda a DHT global.
Backpressure e uso responsável da rede
Quando a entrada supera o downstream, a resposta não deve ser uma queue infinita. É melhor reduzir o active crawl, fundir duplicados e descartar reobservações de baixo valor. Também se deve rate-limit por remote node e usar timeouts razoáveis.
O objetivo é maximizar informação útil por request, não o volume bruto de pacotes UDP.
Esboço de implementação
func handlePacket(pkt []byte, from *net.UDPAddr) {
    msg, err := krpc.Parse(pkt)
    if err != nil { return }
    routing.Observe(msg.NodeID, from)
    if ih, ok := msg.InfoHash(); ok {
        observer.TryEmit(HashEvent{Hash: ih, SeenAt: time.Now()})
    }
}
Notas de engenharia do BT9G Labs
Em um indexador como o BT9G, é mais importante separar corretamente a identidade do conteúdo, observações de rede de curta duração, estado de aquisição e documentos de busca do que maximizar o número bruto de eventos. Campos derivados de DHT ou de um Peer devem manter origem e timestamp, e as métricas devem ser divididas por etapas: discovery, conexão, handshake, suporte a extensões, obtenção de Metadata, validação, armazenamento e indexação.
Erros comuns
- Baixar Metadata de forma síncrona para cada hash visto.
- Executar DB ou I/O lento no handler UDP.
- Afirmar que uma única estratégia cobre toda a DHT.
- Consultar repetidamente o mesmo node em alta frequência.
Artigos relacionados do BT9G Labs
- Por dentro de uma DHT Routing Table: k-Bucket, Node Churn e seleção de contatos
- Por que a DHT vê tantos InfoHash? Swarm Discovery em escala de Internet
- De Magnet Link a Metadata: fluxo completo de Peer Discovery e BEP 9/10
- BEP 9 ut_metadata explicado: obtendo Torrent Metadata de Peer
Referências
Próximo artigo: De Magnet Link a Metadata: fluxo completo de Peer Discovery e BEP 9/10 →
Este artigo descreve o comportamento de protocolos públicos do BitTorrent para fins de engenharia e pesquisa; não implica que todo Swarm observado esteja disponível, seja válido ou autorizado para redistribuição.