
BT9G LABS / DHT Deep Dive #02
Kademlia Dijelaskan: XOR Distance, Routing, dan Skalabilitas BitTorrent DHT
Pahami XOR distance, iterative lookup, parallelism, dan k-bucket yang membuat Kademlia mampu melakukan routing pada jaringan DHT berskala besar.
BT9G Labs / DHT Deep Dive #02. Kademlia memungkinkan setiap node menyimpan hanya sebagian kecil pengetahuan jaringan namun tetap menemukan target secara efisien.
Ringkasan cepat
- Topik: Kademlia Dijelaskan: XOR Distance, Routing, dan Skalabilitas BitTorrent DHT
- Kata kunci utama: Kademlia, XOR distance, DHT routing, k-bucket, iterative lookup
- Untuk pembaca: engineer backend, peneliti protokol, search engineer, dan pengembang implementasi BitTorrent
- Tujuan: Menjelaskan protokol dan desain sistem dengan cukup presisi agar dapat diterapkan pada pipeline discovery, metadata, indexing, dan search di dunia nyata.
Gambaran sistem
Mengapa XOR distance penting
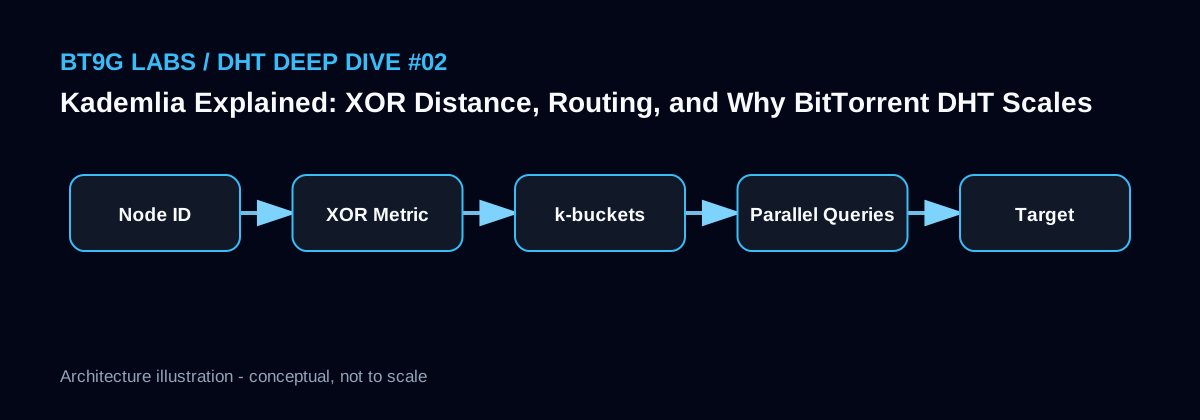
Kademlia menempatkan node ID dan target pencarian di ruang kunci yang sama lalu menggunakan hasil operasi XOR sebagai ukuran jarak logis. Nilai ini mudah dibandingkan, simetris, dan memberikan urutan deterministik tentang node mana yang lebih dekat ke target. Sebuah node tidak perlu mengetahui seluruh jaringan; ia cukup memilih kontak yang secara XOR lebih dekat daripada kandidat sebelumnya.
Jarak XOR tidak merepresentasikan jarak geografis atau latency Internet. Dua server di negara berbeda dapat sangat dekat dalam ruang ID, sedangkan dua server di rack yang sama dapat berjauhan secara logis. Karena itu routing Kademlia tidak boleh diperlakukan seperti pemilihan edge CDN.
Mengapa lookup dapat konvergen
Lookup biasanya dimulai dari beberapa kontak terdekat yang sudah ada di routing table. Klien mengirim query secara paralel, menerima kandidat baru, lalu memilih node yang belum ditanya dengan XOR distance paling kecil. Setiap putaran mempersempit ruang kandidat sampai tidak ada node yang lebih dekat atau hasil yang dicari sudah ditemukan.
Model ini membuat jaringan dapat tumbuh besar tanpa setiap node menyimpan daftar global. Yang dibutuhkan adalah distribusi kontak yang sehat di beberapa rentang jarak dan strategi timeout yang masuk akal. Parallelism meningkatkan kecepatan, tetapi concurrency yang terlalu agresif hanya menambah paket, timeout, dan beban tanpa mempercepat konvergensi secara proporsional.
k-bucket dan routing table
Routing table Kademlia biasanya dibagi menjadi k-bucket berdasarkan rentang distance. Area yang dekat dengan node sendiri dapat memiliki detail lebih tinggi, sedangkan area jauh direpresentasikan lebih kasar. Hasilnya adalah cakupan ruang ID yang luas dengan jumlah kontak terbatas.
Node yang sudah lama hidup dan responsif sering lebih berharga daripada kontak baru yang belum terbukti. Dalam jaringan dengan churn tinggi, mempertahankan kontak stabil membantu routing table tetap berguna. Untuk crawler, kualitas kontak, latency, dan tingkat respons lebih penting daripada sekadar memaksimalkan jumlah node yang disimpan.
Implikasi bagi crawler
Crawler yang efisien seharusnya mempertahankan routing knowledge sendiri, membatasi jumlah inflight query, memberi timeout berbeda berdasarkan observasi, serta menghindari menanyakan node yang sama berulang kali untuk target yang sama. Scheduler dapat menyimpan kandidat, distance, status kunjungan, dan hasil query sebagai struktur terpisah.
Metrik jaringan seperti RTT dan error rate boleh dipakai untuk optimasi, tetapi tidak menggantikan aturan XOR yang menentukan arah lookup. Optimasi transport harus berada di atas algoritme protokol, bukan mengubah makna 'lebih dekat' dalam Kademlia.
Sketsa implementasi
def xor_distance(a: bytes, b: bytes) -> int:
    return int.from_bytes(a, 'big') ^ int.from_bytes(b, 'big')

contacts.sort(key=lambda n: xor_distance(n.node_id, target))
closest = contacts[:8]
Catatan engineering BT9G Labs
Untuk sistem indeks seperti BT9G, metrik yang paling berguna bukan sekadar jumlah paket atau jumlah InfoHash yang terlihat. Pisahkan identitas konten, observasi jaringan, status akuisisi, metadata terverifikasi, serta dokumen pencarian menjadi lapisan data yang berbeda. Simpan sumber dan waktu observasi untuk data yang datang dari DHT atau Peer. Dengan begitu, bottleneck dapat dilacak dari tahap discovery, koneksi, handshake, negosiasi extension, pengambilan metadata, validasi, penyimpanan, hingga indexing.
Kesalahan umum
- Menganggap XOR distance sebagai jarak fisik Internet.
- Mengira setiap node harus menyimpan seluruh jaringan.
- Mengejar routing table sebesar mungkin tanpa menilai kualitas kontak.
- Mengabaikan pengaruh timeout dan parallelism terhadap waktu konvergensi.
Artikel BT9G Labs terkait
- Apa Itu DHT? Panduan Praktis Distributed Hash Table pada BitTorrent
- Cara BitTorrent DHT Menemukan Peer: Bootstrap, get_peers, dan announce_peer
- InfoHash Mendalam: BitTorrent v1, v2, Magnet Link, BTIH, dan BTMH
Referensi
Artikel berikutnya: Cara BitTorrent DHT Menemukan Peer: Bootstrap, get_peers, dan announce_peer →
Artikel ini menjelaskan protokol BitTorrent publik dan pola engineering. Observasi terhadap sebuah Swarm tidak berarti kontennya tersedia, valid, atau diizinkan untuk didistribusikan.