
BT9G LABS / DHT Deep Dive #06
Di Dalam Routing Table DHT: k-Bucket, Node Churn, dan Pemilihan Kontak
Pelajari cara k-bucket membagi ruang XOR, mengapa node stabil bernilai tinggi, dan bagaimana routing table dipelihara di jaringan DHT yang terus berubah.
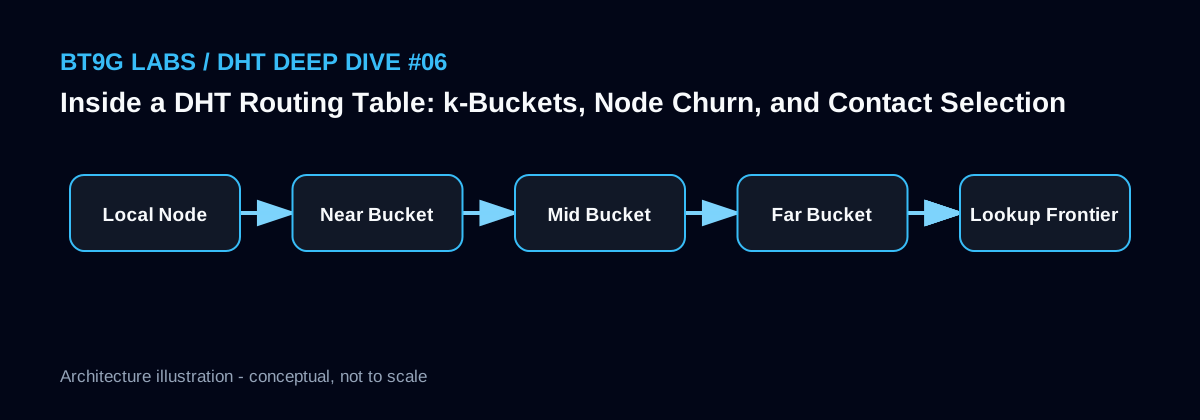
BT9G Labs / DHT Deep Dive #06. Routing table DHT bukan daftar seluruh jaringan, melainkan cache terstruktur dari kontak yang cukup baik untuk mencapai bagian lain dari ruang ID.
Ringkasan cepat
- Topik: Di Dalam Routing Table DHT: k-Bucket, Node Churn, dan Pemilihan Kontak
- Kata kunci utama: k-bucket, DHT routing table, node churn, Kademlia, contact selection
- Untuk pembaca: engineer backend, peneliti protokol, search engineer, dan pengembang implementasi BitTorrent
- Tujuan: Menjelaskan protokol dan desain sistem dengan cukup presisi agar dapat diterapkan pada pipeline discovery, metadata, indexing, dan search di dunia nyata.
Gambaran sistem
Distance band, bukan satu daftar raksasa
Kademlia membagi ruang kontak berdasarkan rentang XOR distance. Setiap k-bucket menyimpan sejumlah terbatas node, sehingga routing table dapat mencakup target dekat dan jauh tanpa tumbuh sebesar jumlah node global.
Pembagian ini membuat pencarian efisien karena klien selalu memiliki beberapa jalan ke berbagai bagian keyspace. Menambah ribuan kontak acak ke satu list tidak memberikan struktur yang sama dan justru membuat pemilihan kandidat lebih mahal.
Mengapa node lama yang responsif bernilai tinggi
Jaringan P2P memiliki churn: node datang dan pergi terus-menerus. Kontak yang sudah lama merespons memiliki bukti stabilitas lebih kuat daripada node baru yang hanya terlihat sekali. Karena itu strategi bucket klasik cenderung mempertahankan node lama selama masih hidup.
Untuk crawler, riwayat success rate, last_seen, RTT, dan jumlah timeout dapat membantu memilih kontak. Namun mekanisme ini sebaiknya melengkapi aturan bucket, bukan menghapus keberagaman distance yang diperlukan untuk routing.
Refresh dan split
Bucket yang sudah lama tidak digunakan perlu di-refresh dengan lookup ke target yang berada pada rentang tersebut. Implementasi juga dapat membagi bucket tertentu ketika penuh, tergantung aturan Kademlia yang dipakai. Tujuan refresh adalah menjaga pengetahuan routing tetap hidup, bukan menghasilkan traffic sebanyak mungkin.
Scheduler harus memberi jitter dan batas concurrency sehingga ribuan bucket tidak melakukan refresh bersamaan setelah proses restart. Persistensi routing state juga dapat mempercepat warm-up selama kontak lama tetap diverifikasi kembali.
Routing table adalah cache, bukan kebenaran
Node ID dan endpoint yang tersimpan bisa menjadi stale. NAT, pergantian IP, restart klien, atau node ID baru dapat membuat kontak lama tidak valid. Karena itu setiap entri perlu status liveness dan timestamp.
Jangan menjadikan routing table sebagai sumber analitik jumlah pengguna atau jumlah node global. Ia adalah struktur kerja lokal yang bias terhadap pola query dan lokasi crawler sendiri.
Sketsa implementasi
type Contact struct {
    ID        [20]byte
    IP        net.IP
    Port      uint16
    LastSeen  time.Time
    Failures  uint8
    RTT       time.Duration
}
Catatan engineering BT9G Labs
Untuk sistem indeks seperti BT9G, metrik yang paling berguna bukan sekadar jumlah paket atau jumlah InfoHash yang terlihat. Pisahkan identitas konten, observasi jaringan, status akuisisi, metadata terverifikasi, serta dokumen pencarian menjadi lapisan data yang berbeda. Simpan sumber dan waktu observasi untuk data yang datang dari DHT atau Peer. Dengan begitu, bottleneck dapat dilacak dari tahap discovery, koneksi, handshake, negosiasi extension, pengambilan metadata, validasi, penyimpanan, hingga indexing.
Kesalahan umum
- Menganggap routing table adalah snapshot lengkap DHT.
- Tidak menyimpan last_seen atau status liveness.
- Menghapus node stabil hanya untuk memberi ruang pada setiap kontak baru.
- Melakukan refresh seluruh bucket secara serentak tanpa rate limit.
Artikel BT9G Labs terkait
- InfoHash Mendalam: BitTorrent v1, v2, Magnet Link, BTIH, dan BTMH
- Pesan DHT BEP 5: ping, find_node, get_peers, dan announce_peer
- Mengapa DHT Melihat Begitu Banyak InfoHash? Memahami Swarm Discovery pada Skala Internet
- Cara DHT Crawler Menemukan InfoHash: Lookup Aktif, Observasi, dan Desain Bertanggung Jawab
Referensi
Artikel ini menjelaskan protokol BitTorrent publik dan pola engineering. Observasi terhadap sebuah Swarm tidak berarti kontennya tersedia, valid, atau diizinkan untuk didistribusikan.