BT9G LABS / DHT 深度解析 #01
DHT 是什么?BitTorrent 分布式哈希表实用指南
深入理解 BitTorrent DHT 如何用基于 Kademlia 的分布式 Peer 发现机制替代中心化 Tracker。
BT9G Labs / DHT Deep Dive #01. 理解 BitTorrent DHT 如何在没有中心服务器的情况下完成 Peer 发现,以及为什么它是现代 BitTorrent 网络的核心基础设施。
快速摘要
- 主题: DHT 是什么?BitTorrent 分布式哈希表实用指南
- 核心关键词: DHT, BitTorrent DHT, 分布式哈希表, Peer 发现, Kademlia
- 适合读者: 后端工程师、协议研究者、搜索工程师以及 BitTorrent 实现者
- 目标: 用足够准确的协议与系统视角解释原理,并能直接支持真实的采集、索引和搜索架构设计。
系统视图
DHT 解决了什么问题
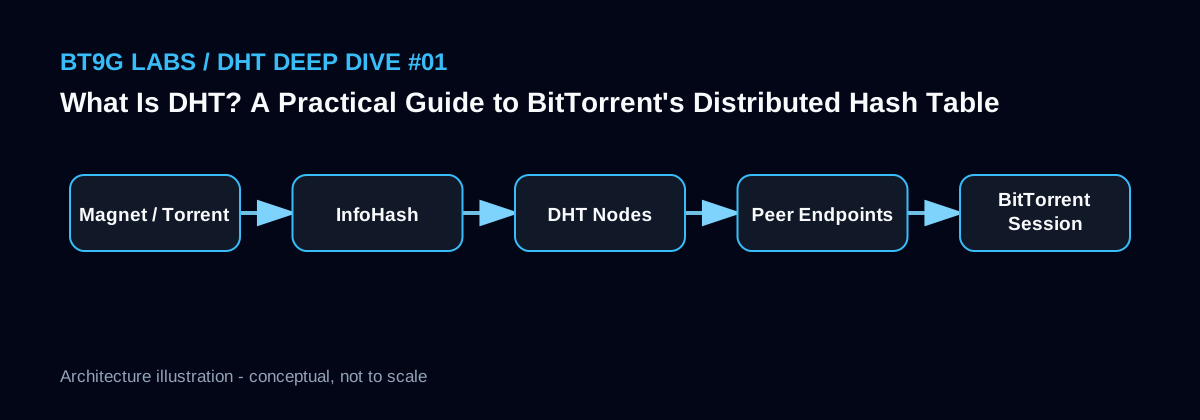
BitTorrent 客户端仅知道一个内容标识还不够,它还必须找到正在参与同一 Swarm 的其他 Peer。传统 Tracker 会在服务器端维护 InfoHash 到 Peer 地址的映射,结构简单,但会形成一个需要长期在线、可访问的中心节点。
DHT 把这层“寻找参与者”的能力分散到大量节点上。客户端不再只询问一个 Tracker,而是不断查询在 XOR 距离上更接近目标 InfoHash 的 DHT 节点,直到获得 Peer 地址或更接近目标的节点集合。BEP 5 中的 DHT node 与实际传输内容的 BitTorrent Peer 是两个不同概念。
一个更容易理解的心智模型
可以把 DHT 看成一个规模巨大、持续变化的分布式地址簿。键通常是 Torrent 的内容标识,而返回值并不是文件本身,而是声称参与该 Swarm 的 Peer 联系方式。换句话说,DHT 更擅长回答“谁可能拥有这个内容”,而不是“这个 Torrent 里面有什么文件”。
文件名、目录和大小等信息属于 Metadata,需要在找到 Peer 后再通过 BitTorrent 扩展协议获取。这个区分非常重要,因为搜索引擎系统应该把“发现一个 InfoHash”和“已经拿到可信 Metadata”设计成两个不同阶段。
从冷启动到找到 Peer
一个新客户端首先通过已知 bootstrap 节点或历史缓存联系人加入 DHT,并用 find_node 等查询逐渐建立 routing table。当它要寻找某个 InfoHash 对应的 Peer 时,会发起迭代式 get_peers 查询,持续靠近目标键空间。响应可能直接包含 compact peer endpoints,也可能只提供一批更接近目标的节点。
如果客户端随后要声明自己也参与该 Swarm,会用之前 get_peers 返回的 token 发送 announce_peer。这个 token 可以降低盲目写入和部分放大攻击风险,因为发送方必须先从目标节点拿到一个近期有效的令牌。
DHT 不保证什么
DHT 不是一个拥有永久记录和一致事务语义的全球数据库。节点会离线,NAT 会改变端口映射,Peer 会快速变化,冷门资源可能暂时没有任何可连接节点,恶意参与者也可能发送垃圾数据。因此一次查询失败不能直接等同于“这个 Torrent 已经死亡”。
对索引系统来说,更合理的做法是长期保存内容身份,同时把 Peer 地址、最近活跃时间、查询成功率等视为易失的网络观察。只要把稳定数据与短期观测解耦,就能在数月甚至数年后再次利用新活动信号重新激活旧 InfoHash。
实现示意
// Conceptual lookup loop. Production code needs transaction IDs,
// compact-node parsing, timeouts, retries, and routing-table maintenance.
for frontier.NotEmpty() {
    node := frontier.PopClosest(targetInfoHash)
    resp, err := dht.GetPeers(node, targetInfoHash)
    if err != nil { continue }
    peers.Add(resp.Peers...)
    frontier.Add(resp.CloserNodes...)
}
BT9G Labs 工程笔记
对 BT9G 一类索引系统而言,最重要的不是单纯追求事件数量,而是把内容身份、网络观察、采集状态和搜索文档拆成清晰的数据层。所有来自 DHT 或 Peer 的字段都应该保留来源与时间戳,并通过阶段化指标区分发现、连接、协商、Metadata 获取、校验、入库和索引等环节。这样才能在规模扩大后定位真实瓶颈,而不是把所有失败都归因于“网络不稳定”。
常见误区
- 把 DHT node 和 BitTorrent Peer 当成同一个概念。
- 把一次观察到的 Peer 地址当成永久数据。
- 一次查询失败就判断资源永久失效。
- 误以为 DHT 本身会直接返回文件名和文件大小。
相关 BT9G Labs 文章
- Kademlia 原理详解:XOR 距离、路由与 BitTorrent DHT 的可扩展性
- BitTorrent DHT 如何找到 Peer:从 Bootstrap 到 get_peers 与 announce_peer
参考资料
下一篇: Kademlia 原理详解:XOR 距离、路由与 BitTorrent DHT 的可扩展性 →
本文用于解释公开的 BitTorrent 协议与工程实现思路,不代表任何被观察到的 Swarm 一定可用、有效或被授权传播。