
BT9G LABS / DHT Deep Dive #02
Kademlia: XOR-расстояние, маршрутизация и масштабируемость BitTorrent DHT
Практическое объяснение XOR distance, итеративного поиска, параллелизма и k-bucket в Kademlia-подобной DHT.
BT9G Labs / DHT Deep Dive #02. Почему узлу достаточно небольшой таблицы контактов, чтобы находить цели в сети из миллионов участников.
Краткое резюме
- Тема: Kademlia: XOR-расстояние, маршрутизация и масштабируемость BitTorrent DHT
- Ключевые слова: Kademlia, XOR distance, DHT routing, k-bucket, итеративный поиск
- Для кого: backend-разработчики, исследователи протоколов, инженеры поисковых систем и разработчики BitTorrent-клиентов
- Цель: Объяснить механизм достаточно точно, чтобы на его основе можно было принимать реальные архитектурные решения для краулинга, индексации и поиска.
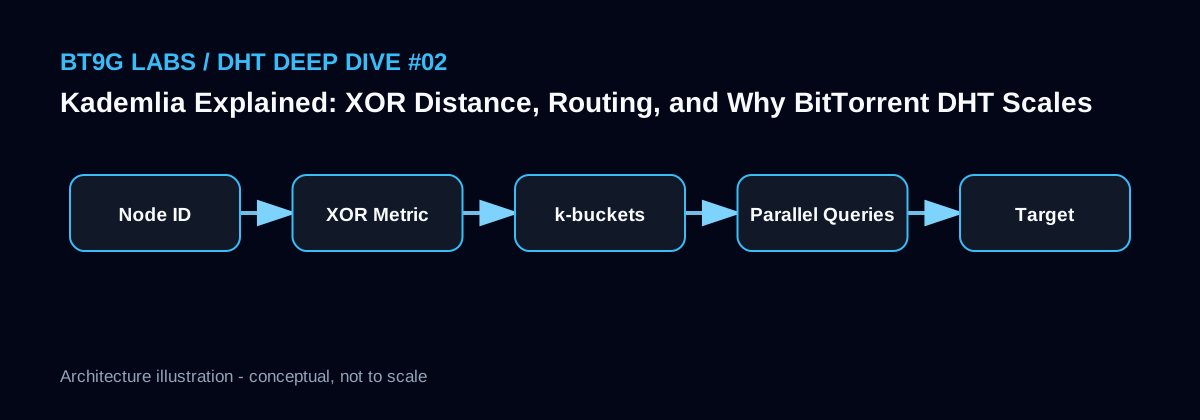
Системная схема
Почему XOR-расстояние работает
Kademlia помещает Node ID и целевые ключи в одно логическое пространство и сравнивает их через XOR. Это расстояние детерминировано, симметрично и удобно для сортировки: узел может выбрать контакты, которые логически ближе к цели, не зная всю сеть.
Логическая близость никак не равна географической. Два сервера в одной стойке могут быть далеко друг от друга в пространстве ID, а узлы на разных континентах — близко. Поэтому XOR нельзя использовать как замену измерению RTT.
Почему lookup сходится
Клиент выбирает несколько ближайших известных контактов, делает запросы параллельно и добавляет из ответов еще более близкие узлы. Каждая итерация сужает фронтир поиска. Процесс заканчивается, когда более близких кандидатов не остается либо найден нужный результат.
Такой алгоритм масштабируется, потому что ни один участник не обязан хранить полный список сети. Достаточно качественного покрытия разных диапазонов расстояний.
k-bucket и практический краулинг
Routing table делится на k-bucket по диапазонам XOR-расстояния. Старые отвечающие узлы часто ценнее только что увиденных: в P2P-сети высокий churn, и стабильный контакт повышает вероятность успешного следующего lookup.
Crawler должен поддерживать routing knowledge, ограничивать параллелизм, учитывать таймауты и избегать повторных запросов. Дополнительные метрики вроде RTT и доли ошибок полезны для планирования, но не должны ломать базовую Kademlia-логику выбора ближайших узлов.
Эскиз реализации
def xor_distance(a: bytes, b: bytes) -> int:
    return int.from_bytes(a, 'big') ^ int.from_bytes(b, 'big')

contacts.sort(key=lambda n: xor_distance(n.node_id, target))
closest = contacts[:8]
Инженерные заметки BT9G Labs
Для индексатора уровня BT9G важнее не максимальное число событий, а правильное разделение идентичности контента, краткоживущих сетевых наблюдений, состояния сбора и поискового представления. Поля, полученные из DHT или от Peer, должны иметь источник и временную метку. Метрики стоит вести по этапам: discovery, соединение, handshake, поддержка расширений, получение Metadata, проверка, сохранение и индексация. Это позволяет видеть реальное узкое место системы, а не списывать все неудачи на «нестабильную сеть».
Типичные ошибки
- Путать XOR-расстояние с сетевой или географической задержкой.
- Считать, что каждый узел должен знать всю DHT.
- Увеличивать routing table без оценки качества контактов.
- Игнорировать параллелизм и таймауты при lookup.
Связанные статьи BT9G Labs
- Что такое DHT в BitTorrent: практическое руководство по распределенной хеш-таблице
- Как BitTorrent DHT находит Peer: от bootstrap до get_peers и announce_peer
- InfoHash в деталях: BitTorrent v1, v2, Magnet, BTIH и BTMH
Источники
Следующая статья: Как BitTorrent DHT находит Peer: от bootstrap до get_peers и announce_peer →
Материал описывает публичное поведение протоколов BitTorrent для инженерных и исследовательских целей и не означает, что любой наблюдаемый Swarm доступен, корректен или разрешен к распространению.