
BT9G LABS / DHT em profundidade #02
Kademlia explicado: distância XOR, routing e por que o BitTorrent DHT escala
Explicação prática de XOR distance, lookup iterativo, paralelismo e k-bucket em uma DHT baseada em Kademlia.
BT9G Labs / DHT Deep Dive #02. Entenda como milhões de nodes podem localizar uma chave mantendo apenas um conjunto limitado de contatos.
Resumo rápido
- Tema: Kademlia explicado: distância XOR, routing e por que o BitTorrent DHT escala
- Palavras-chave: Kademlia, XOR distance, DHT routing, k-bucket, lookup iterativo
- Público: engenheiros backend, pesquisadores de protocolos, engenheiros de busca e implementadores de BitTorrent
- Objetivo: Explicar o mecanismo com precisão suficiente para orientar decisões reais de arquitetura de crawling, indexação e busca.
Visão do sistema
Por que a distância XOR importa
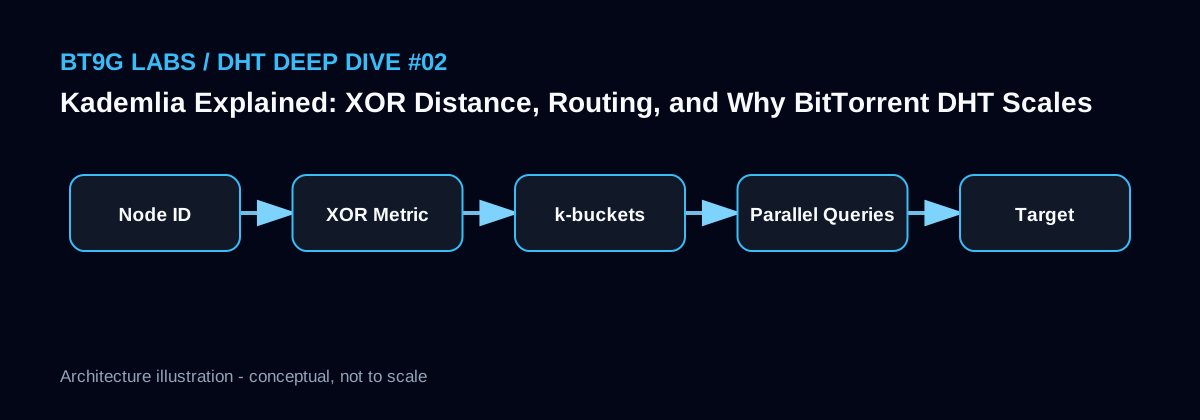
Kademlia coloca Node ID e chaves-alvo no mesmo espaço lógico e usa XOR para comparar distâncias. A métrica é determinística, simétrica e fácil de ordenar, permitindo que cada node escolha quais contatos estão logicamente mais próximos sem conhecer toda a rede.
Essa proximidade não representa geografia nem RTT. Dois hosts no mesmo datacenter podem estar distantes no espaço de IDs, enquanto nodes em continentes diferentes podem estar próximos.
Por que os lookups convergem
O cliente escolhe alguns contatos próximos ao alvo, consulta em paralelo e adiciona à fronteira os nodes ainda mais próximos retornados nas respostas. A cada rodada a distância lógica diminui até encontrar o resultado ou não haver candidatos melhores.
Esse comportamento permite escala porque nenhum participante precisa armazenar a lista completa da rede.
k-bucket e implicações para crawlers
A routing table é organizada em k-bucket por faixas de distância. Em uma rede com muito churn, um node antigo que respondeu repetidamente costuma ser mais valioso que um endereço recém-observado.
Um crawler eficiente mantém routing knowledge, limita paralelismo, controla timeouts e evita consultas duplicadas. RTT pode ser uma métrica auxiliar, mas não deve substituir a lógica XOR fundamental.
Esboço de implementação
def xor_distance(a: bytes, b: bytes) -> int:
    return int.from_bytes(a, 'big') ^ int.from_bytes(b, 'big')

contacts.sort(key=lambda n: xor_distance(n.node_id, target))
closest = contacts[:8]
Notas de engenharia do BT9G Labs
Em um indexador como o BT9G, é mais importante separar corretamente a identidade do conteúdo, observações de rede de curta duração, estado de aquisição e documentos de busca do que maximizar o número bruto de eventos. Campos derivados de DHT ou de um Peer devem manter origem e timestamp, e as métricas devem ser divididas por etapas: discovery, conexão, handshake, suporte a extensões, obtenção de Metadata, validação, armazenamento e indexação.
Erros comuns
- Interpretar XOR distance como distância física ou latência.
- Achar que cada node precisa armazenar toda a DHT.
- Otimizar apenas pelo tamanho da routing table.
- Ignorar paralelismo e timeouts no lookup.
Artigos relacionados do BT9G Labs
- O que é DHT? Guia prático da tabela hash distribuída do BitTorrent
- Como o BitTorrent DHT encontra Peer: do bootstrap a get_peers e announce_peer
- InfoHash em detalhes: BitTorrent v1, v2, Magnet, BTIH e BTMH
Referências
Próximo artigo: Como o BitTorrent DHT encontra Peer: do bootstrap a get_peers e announce_peer →
Este artigo descreve o comportamento de protocolos públicos do BitTorrent para fins de engenharia e pesquisa; não implica que todo Swarm observado esteja disponível, seja válido ou autorizado para redistribuição.