
BT9G LABS / DHT 심층 분석 #16
분당 1,000+ Torrent Metadata를 가져오려면 무엇이 필요한가
성공 처리량, Peer discovery, 연결 성공률, timeout budget, concurrency를 기준으로 Metadata pipeline을 용량 계획합니다.
BT9G Labs / DHT Deep Dive #16. 보낸 request 수가 아니라 검증 완료된 Metadata 성공 수에서 필요한 병렬도를 역산합니다.
빠른 요약
- 주제: 분당 1,000+ Torrent Metadata를 가져오려면 무엇이 필요한가
- 핵심 키워드: 1000 metadata/min, Metadata pipeline, concurrency, Little's Law, BitTorrent crawler
- 대상 독자: 백엔드 엔지니어, 프로토콜 연구자, 검색 엔지니어, BitTorrent 구현자
- 목표: DHT와 BitTorrent의 동작 원리를 실제 크롤러, 인덱싱, 검색 아키텍처 설계에 활용할 수 있을 정도로 정확하게 설명합니다.
시스템 뷰
성공 처리량에서 시작한다
1,000건/분은 약 16.7 successful Metadata/s입니다. 최종 validation까지 도달하는 비율이 20%라면 80회/s 이상의 유효 attempt가 필요할 수 있습니다. InfoHash discovery rate와 Metadata success rate는 완전히 다른 지표입니다.
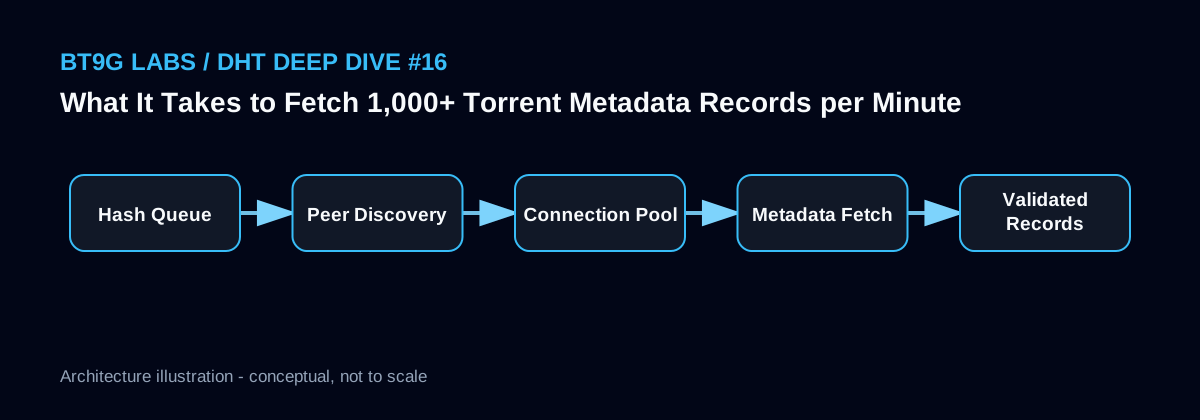
hash → Peer candidate → connected → extension supported → validated metadata의 conversion을 단계별로 봐야 합니다.
Little's Law로 1차 추정
평균 task 시간이 5초이고 80 attempts/s를 처리한다면 단순 평균만으로 약 400개의 in-flight task가 필요합니다. 실제로는 긴 timeout tail 때문에 여유가 더 필요합니다. 하지만 concurrency를 계속 올리면 FD, NAT/conntrack, bandwidth, CPU, remote Peer limit에 막힙니다.
계산은 출발점이지 benchmark 대체물이 아닙니다.
Peer 품질과 호스트 한계
상류에서 연결 가능한 Peer를 충분히 공급하지 못하면 Metadata worker를 늘려도 성공률은 오르지 않습니다. 최근 activity, 과거 응답 성공, 다중 소스 확인을 이용한 후보 우선순위가 단순한 connection 폭증보다 효과적일 수 있습니다.
2c4g/4c8g의 실제 성능은 배포 지역에서 p50/p95/p99와 queue, failure class를 포함해 부하 테스트해야 합니다.
구현 스케치
Target: 1000 validated metadata / minute
      = 16.7 successes / second

Required attempt rate ~= success_rate_target / end_to_end_success_ratio
Required concurrency ~= attempt_rate * average_session_seconds

Example only:
16.7 / 0.25 * 4s ~= 267 concurrent session slots
BT9G Labs 엔지니어링 노트
BT9G 같은 인덱싱 시스템에서는 이벤트 수 자체보다 콘텐츠 식별자, 수명이 짧은 네트워크 관측값, 수집 상태, 검색용 문서를 분리하는 것이 중요합니다. DHT나 Peer에서 얻은 필드에는 출처와 타임스탬프를 남기고, discovery, 연결, handshake, 확장 지원, Metadata 수집, 검증, 저장, 검색 반영을 단계별로 측정해야 실제 병목을 찾을 수 있습니다.
흔한 오해
- 1,000 discovered hash를 1,000 Metadata 성공과 혼동하는 것.
- 평균 latency만으로 concurrency를 정하는 것.
- 좋은 Peer 공급 없이 worker만 늘리는 것.
- 실제 benchmark 없이 VPS 사양만으로 throughput을 단정하는 것.
관련 BT9G Labs 글
- Torrent Metadata 수집이 실패하는 10가지 이유와 더 나은 Retry 모델
- 고성능 DHT Crawler 설계: 아키텍처, Queue, Backpressure
- 수십억 InfoHash를 Dedup하는 법: 중복 Metadata 작업을 줄이는 다층 설계
- 실패한 InfoHash도 남겨야 하는 이유: 장기 Retry Scheduler 설계
참고 자료
다음 글: 수십억 InfoHash를 Dedup하는 법: 중복 Metadata 작업을 줄이는 다층 설계 →
이 글은 공개 BitTorrent 프로토콜의 동작을 엔지니어링 및 연구 목적으로 설명하며, 관측된 모든 Swarm이 사용 가능하거나 유효하거나 재배포 허가를 받았음을 의미하지 않습니다.