
BT9G LABS / DHT 詳解 #14
Torrent Metadata取得が失敗する10の理由と、より良いRetryモデル
Metadata timeout、死んだ Swarm、拡張非対応、悪い Peer、scheduler 設定ミスを切り分けます。
BT9G Labs / DHT Deep Dive #14. インターネット規模では失敗は正常です。重要なのは失敗段階を分類し、再試行タイミングを賢く決めることです。
クイックサマリー
- テーマ: Torrent Metadata取得が失敗する10の理由と、より良いRetryモデル
- 主要キーワード: Metadata timeout, Torrent Metadata, retry, DHT crawler, Peer failure
- 対象読者: バックエンドエンジニア、プロトコル研究者、検索エンジニア、BitTorrent 実装者
- 目的: DHT と BitTorrent の仕組みを、実際のクローラ・インデックス・検索基盤の設計判断に使える精度で説明すること。
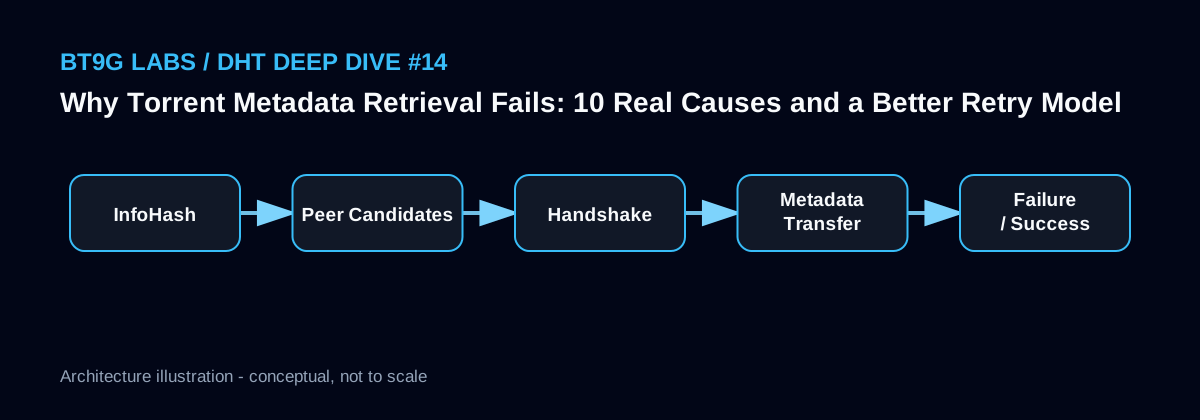
システム構成
失敗は通常の状態
InfoHash が存在しても、その瞬間に接続可能で ut_metadata を提供する Peer がいるとは限りません。DHT timeout、古い endpoint、NAT、connection refused、handshake mismatch、BEP 10 非対応、transfer 中断など複数の段階で失敗します。
すべてを 1 つの failed=true にすると改善点が分からなくなります。
代表的な10原因
実務では、Peer 不在、DHT convergence failure、stale endpoint、接続不可、InfoHash mismatch、BEP 10 非対応、ut_metadata 非対応、transfer timeout、bad piece/hash mismatch、ローカルの timeout/concurrency 設定過剰などが典型です。
同じ InfoHash でも試行ごとに原因は変わります。
Backoff と reactivation
短い network error は比較的早く再試行し、長期間 activity のない cold hash は指数的に間隔を延ばします。ただし新しい announce や Peer activity が来たら、古い backoff を待たず優先度を上げます。
attempt_count、last_error_class、next_attempt_at、last_activity_at を durable に持つと運用しやすくなります。
実装スケッチ
NEW -> peer discovery
  no peers -> retry in 30m, 2h, 8h, 1d, 7d...
  peers found -> handshake
      no BEP10/9 -> try another peer
      transfer timeout -> peer penalty + retry
      valid metadata -> COMPLETE

fresh observation -> reduce backoff and re-queue
BT9G Labs エンジニアリングノート
BT9G のようなインデックス基盤では、イベント件数そのものより、コンテンツ ID、短命なネットワーク観測、取得状態、検索用ドキュメントを分離することが重要です。DHT や Peer から得た値には取得元と時刻を持たせ、discovery、接続、handshake、拡張対応、Metadata 取得、検証、保存、検索反映を段階別に計測すると、実際のボトルネックを特定しやすくなります。
よくある誤解
- 全 failure を 1 種類として記録する。
- 1 回失敗した InfoHash を永久に捨てる。
- 全 task に同じ retry interval を使う。
- 新 activity があっても古い backoff を維持する。
関連する BT9G Labs 記事
- Tracker vs DHT vs PEX:BitTorrentの3つのPeer Discovery方式を比較
- SeedersとLeechersとは?数字の意味と測定方法
- 高性能DHT Crawler設計:アーキテクチャ、Queue、Backpressure
- 1分1,000件以上のTorrent Metadataを取得するには何が必要か
参考資料
次の記事: 高性能DHT Crawler設計:アーキテクチャ、Queue、Backpressure →
本記事は公開 BitTorrent プロトコルの挙動を技術・研究目的で解説するものであり、観測されたすべての Swarm が利用可能、正当、または再配布を許可されていることを意味しません。