
BT9G LABS / DHT 詳解 #18
失敗したInfoHashを残すべき理由:長期Retry Scheduler設計
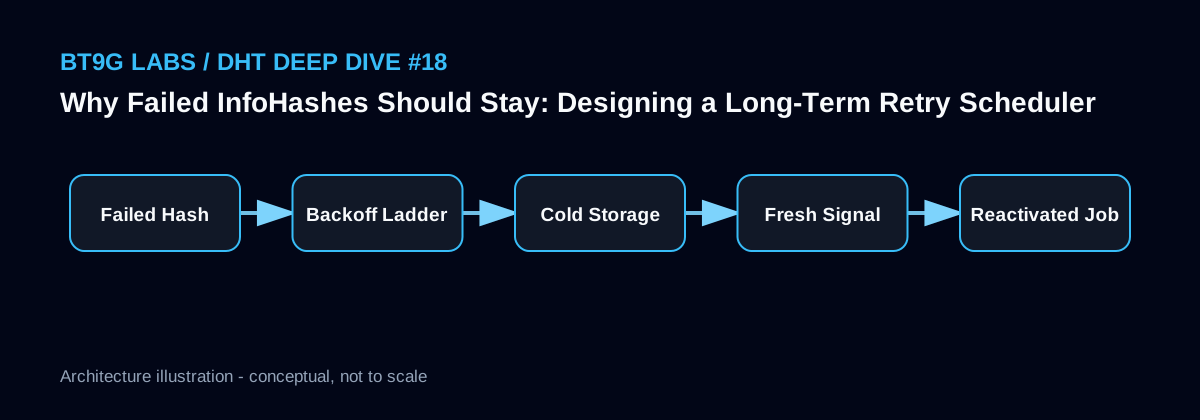
過去 hash を保持し、cold Swarm は backoff し、新 activity で即座に再活性化する retry モデルを設計します。
BT9G Labs / DHT Deep Dive #18. 失敗は tombstone ではなく時点観測。安価な state を残し、ネットワーク試行頻度だけを調整します。
クイックサマリー
- テーマ: 失敗したInfoHashを残すべき理由:長期Retry Scheduler設計
- 主要キーワード: InfoHash retry, exponential backoff, cold swarm, scheduler, Metadata retry
- 対象読者: バックエンドエンジニア、プロトコル研究者、検索エンジニア、BitTorrent 実装者
- 目的: DHT と BitTorrent の仕組みを、実際のクローラ・インデックス・検索基盤の設計判断に使える精度で説明すること。
システム構成
失敗時刻は墓標ではない
今日 Metadata が取れなくても、数週間後に新しい Peer が現れる可能性があります。InfoHash を削除すると過去の状態を失います。ハッシュと少量 state を残すコストは低く、何度も network attempt するコストの方が高いので、保存したまま retry interval を伸ばす方が合理的です。
長期 ledger が再発見時にも役立ちます。
Error typeごとにBackoffする
DHT timeout、connection refused、unsupported ut_metadata、hash mismatch は意味が違います。短い一時障害は早めに再試行し、長期間 Peer 不在の hash は数日単位へ指数 backoff できます。
ただし最大間隔と wake-up 条件を持たせ、永久放置にならないようにします。
Fresh activityが古い判断を上書きする
新しい announce、Peer、Tracker signal が来たら、数か月前の failure より新情報を優先して next_attempt_at を前倒しします。retry queue 自体も durable にし、worker crash や deploy 後に予定が消えない設計にします。
lease/claim 方式を使うと重複処理も抑えられます。
実装スケッチ
attempt 1: +30 minutes
attempt 2: +2 hours
attempt 3: +8 hours
attempt 4: +1 day
attempt 5: +7 days
attempt 6+: +30 days with jitter

fresh DHT observation => move next_retry closer
BT9G Labs エンジニアリングノート
BT9G のようなインデックス基盤では、イベント件数そのものより、コンテンツ ID、短命なネットワーク観測、取得状態、検索用ドキュメントを分離することが重要です。DHT や Peer から得た値には取得元と時刻を持たせ、discovery、接続、handshake、拡張対応、Metadata 取得、検証、保存、検索反映を段階別に計測すると、実際のボトルネックを特定しやすくなります。
よくある誤解
- 1 回 failure で InfoHash を削除する。
- 全 error に同じ retry interval を使う。
- fresh activity が来ても古い backoff を維持する。
- 長期 retry queue を RAM だけに置く。
関連する BT9G Labs 記事
- 1分1,000件以上のTorrent Metadataを取得するには何が必要か
- 数十億InfoHashをどうDedupするか:無駄なMetadata作業を防ぐ多層設計
- BitTorrent検索インデックスを作る:DHTからMetadata、Elasticsearchまで
- BT9GがBitTorrent Metadataを大規模索引するための参照DHTアーキテクチャ
参考資料
次の記事: BitTorrent検索インデックスを作る:DHTからMetadata、Elasticsearchまで →
本記事は公開 BitTorrent プロトコルの挙動を技術・研究目的で解説するものであり、観測されたすべての Swarm が利用可能、正当、または再配布を許可されていることを意味しません。